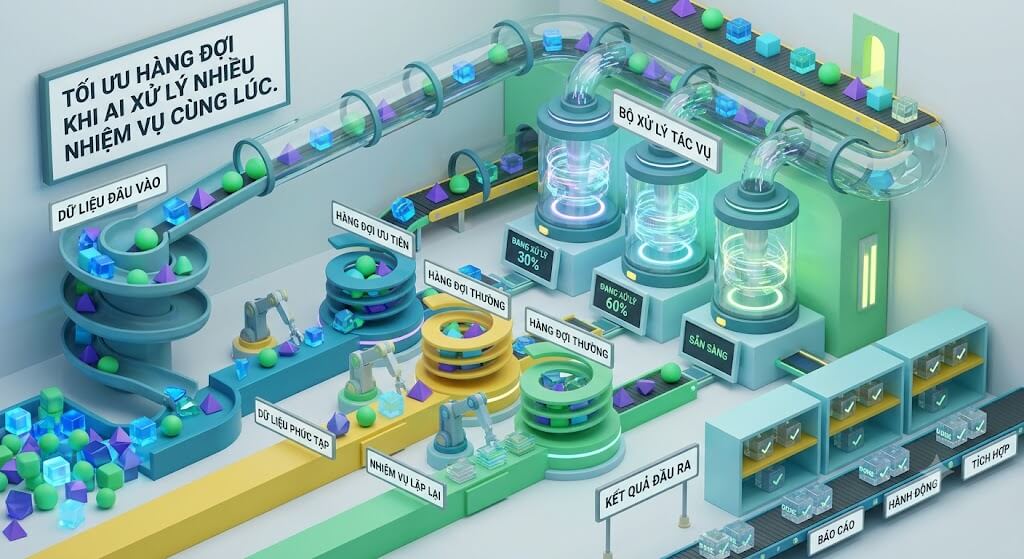
Tìm hiểu cách tối ưu hàng đợi khi AI xử lý nhiều nhiệm vụ cùng lúc, từ phân loại mức độ ưu tiên, phân bổ tài nguyên đến kiểm soát thời gian chờ và hạn chế quá tải hệ thống.
Khi doanh nghiệp sử dụng AI để xử lý nhiều yêu cầu cùng lúc, hệ thống có thể gặp tình trạng quá tải, phản hồi chậm hoặc một số nhiệm vụ phải chờ quá lâu. Nguyên nhân không chỉ nằm ở năng lực xử lý của mô hình AI mà còn liên quan đến cách tổ chức và vận hành hàng đợi công việc.
Tối ưu hàng đợi giúp hệ thống phân phối nhiệm vụ hợp lý, tận dụng tài nguyên hiệu quả và duy trì tốc độ phản hồi ổn định. Đây là yếu tố quan trọng khi triển khai AI Agent, chatbot hoặc các quy trình tự động hóa có số lượng yêu cầu lớn.
1. Hàng đợi trong hệ thống AI là gì?
Hàng đợi (Queue) là cơ chế lưu trữ và sắp xếp các nhiệm vụ đang chờ được xử lý. Khi nhiều yêu cầu gửi đến cùng một thời điểm, hệ thống không nhất thiết phải thực hiện tất cả ngay lập tức. Thay vào đó, các nhiệm vụ được đưa vào hàng đợi và phân phối cho những bộ phận có khả năng xử lý.
Ví dụ, một chatbot AI của doanh nghiệp có thể tiếp nhận đồng thời nhiều yêu cầu như:
- Trả lời câu hỏi về sản phẩm và dịch vụ.
- Tra cứu thông tin đơn hàng.
- Phân tích tài liệu do khách hàng tải lên.
- Tạo báo cáo từ dữ liệu nội bộ.
- Chuyển yêu cầu phức tạp đến AI Agent chuyên trách.
Nếu không có cơ chế quản lý hàng đợi, các yêu cầu có thể tranh giành tài nguyên xử lý, khiến hệ thống phản hồi chậm hoặc phát sinh lỗi.
Trong kiến trúc AI, hàng đợi thường hoạt động giữa bước tiếp nhận yêu cầu và bước thực thi nhiệm vụ. Hệ thống có thể sử dụng các công cụ như RabbitMQ, Apache Kafka hoặc Redis để lưu trữ, phân phối và theo dõi trạng thái công việc.
2. Vì sao cần tối ưu hàng đợi khi AI xử lý nhiều nhiệm vụ?
Một hệ thống AI có thể tiếp nhận hàng trăm hoặc hàng nghìn yêu cầu trong thời gian ngắn. Nếu số lượng nhiệm vụ vượt quá khả năng xử lý hiện tại, hàng đợi sẽ ngày càng dài và làm giảm hiệu suất tổng thể.
Tối ưu hàng đợi giúp giải quyết một số vấn đề phổ biến:
Giảm thời gian chờ: Những nhiệm vụ có mức độ ưu tiên cao được xử lý sớm hơn, hạn chế tình trạng người dùng phải chờ lâu.
Tránh quá tải tài nguyên: Hệ thống kiểm soát số lượng tác vụ được thực thi đồng thời, tránh sử dụng quá mức CPU, GPU, bộ nhớ hoặc giới hạn API.
Hạn chế lỗi dây chuyền: Khi một dịch vụ AI gặp sự cố, hàng đợi có thể giữ lại những nhiệm vụ chưa xử lý để hệ thống tiếp tục thực hiện sau khi phục hồi.
Tăng khả năng mở rộng: Khi lượng yêu cầu tăng, doanh nghiệp có thể bổ sung thêm worker hoặc tài nguyên xử lý mà không cần thay đổi toàn bộ kiến trúc.
Cải thiện trải nghiệm người dùng: Các yêu cầu được phân phối hợp lý giúp hệ thống duy trì tốc độ phản hồi ổn định hơn, kể cả trong thời điểm có nhiều người truy cập.
3. Những yếu tố ảnh hưởng đến hiệu suất hàng đợi AI
Để tối ưu hiệu quả, doanh nghiệp cần xác định những yếu tố khiến hàng đợi bị ùn tắc. Không phải mọi nhiệm vụ AI đều có thời gian và mức tài nguyên xử lý giống nhau.
Một số yếu tố quan trọng bao gồm:
- Số lượng yêu cầu đồng thời: Khi lượng yêu cầu đến nhanh hơn tốc độ xử lý, số nhiệm vụ chờ sẽ tăng.
- Độ phức tạp của nhiệm vụ: Tạo câu trả lời ngắn thường nhanh hơn phân tích tài liệu dài hoặc xử lý dữ liệu lớn.
- Giới hạn tài nguyên: GPU, RAM, CPU và giới hạn số lượt gọi API có thể làm giảm số nhiệm vụ được thực hiện cùng lúc.
- Khả năng xử lý của worker: Worker là thành phần trực tiếp nhận và thực hiện công việc. Nếu số lượng worker quá ít, hàng đợi dễ bị ùn tắc.
- Thời gian phản hồi từ dịch vụ bên ngoài: AI có thể phải chờ dữ liệu từ API, cơ sở dữ liệu hoặc công cụ khác trước khi hoàn thành nhiệm vụ.
Ngoài ra, các tác vụ phụ thuộc lẫn nhau cũng cần được xem xét. Chẳng hạn, một AI Agent phải hoàn thành bước tìm kiếm dữ liệu trước khi chuyển sang bước phân tích. Nếu bước đầu bị chậm, toàn bộ quy trình phía sau cũng bị ảnh hưởng.
4. Các phương pháp tối ưu hàng đợi khi AI xử lý nhiều nhiệm vụ
Có nhiều cách cải thiện hiệu suất hàng đợi. Doanh nghiệp nên lựa chọn phương pháp dựa trên loại nhiệm vụ, mức độ ưu tiên và năng lực hạ tầng hiện có.
Phân loại nhiệm vụ theo mức độ ưu tiên
Không nên xử lý mọi yêu cầu theo cùng một thứ tự. Hệ thống có thể chia nhiệm vụ thành các nhóm như:
- Ưu tiên cao: yêu cầu cần phản hồi ngay, tác vụ quan trọng đối với hoạt động kinh doanh.
- Ưu tiên trung bình: các yêu cầu thông thường từ người dùng.
- Ưu tiên thấp: công việc chạy nền như tổng hợp báo cáo, phân tích dữ liệu định kỳ.
Cách phân loại này giúp hệ thống sử dụng tài nguyên phù hợp hơn. Tuy nhiên, cần có cơ chế chống bỏ đói nhiệm vụ (Starvation), tránh để những công việc ưu tiên thấp phải chờ vô thời hạn.
Giới hạn số nhiệm vụ xử lý đồng thời
Tăng số lượng tác vụ chạy cùng lúc không phải lúc nào cũng giúp hệ thống nhanh hơn. Nếu vượt quá khả năng tài nguyên, các nhiệm vụ có thể cạnh tranh CPU, GPU và bộ nhớ, khiến thời gian xử lý tăng lên.
Doanh nghiệp nên thiết lập giới hạn đồng thời phù hợp với năng lực hệ thống. Ví dụ, các tác vụ phân tích tài liệu lớn có thể được giới hạn số lượng chạy cùng lúc, trong khi yêu cầu chatbot đơn giản được xử lý với mức đồng thời cao hơn.
Sử dụng nhiều worker để phân phối công việc
Worker là các tiến trình hoặc dịch vụ nhận nhiệm vụ từ hàng đợi và thực hiện chúng. Khi có nhiều worker, hệ thống có thể xử lý nhiều yêu cầu song song thay vì phụ thuộc vào một tiến trình duy nhất.
Có thể phân chia worker theo loại công việc:
- Worker xử lý hội thoại và phản hồi người dùng.
- Worker phân tích tài liệu và hình ảnh.
- Worker thực hiện tác vụ nền.
- Worker gọi API hoặc truy xuất dữ liệu bên ngoài.
Cách tổ chức này giúp hạn chế việc một nhóm nhiệm vụ chiếm dụng toàn bộ năng lực xử lý của hệ thống.
Áp dụng cơ chế Batch Processing
Batch Processing là phương pháp gom nhiều nhiệm vụ tương tự thành một nhóm để xử lý trong cùng một lượt. Cách này có thể giảm chi phí xử lý và tận dụng tài nguyên tốt hơn, đặc biệt với các mô hình AI hỗ trợ xử lý theo batch.
Ví dụ, thay vì gửi từng yêu cầu phân loại văn bản riêng lẻ, hệ thống có thể gom nhiều văn bản thành một batch để xử lý. Tuy nhiên, cần cân bằng kích thước batch với thời gian chờ, bởi việc chờ đủ dữ liệu để gom nhóm có thể làm tăng độ trễ.
Thiết lập cơ chế Retry và Dead Letter Queue
Trong quá trình vận hành, một số nhiệm vụ có thể thất bại do lỗi API, mất kết nối hoặc dịch vụ AI tạm thời không phản hồi.
Cơ chế Retry cho phép hệ thống thử thực hiện lại nhiệm vụ sau một khoảng thời gian nhất định. Trong khi đó, Dead Letter Queue (DLQ) lưu những nhiệm vụ đã thất bại sau số lần thử được quy định để kiểm tra và xử lý riêng.
Điều này giúp hệ thống không bị mắc kẹt vì một nhiệm vụ lỗi và hạn chế việc lặp lại liên tục những yêu cầu không thể hoàn thành.
5. Quy trình triển khai tối ưu hàng đợi cho hệ thống AI
Để tối ưu hàng đợi hiệu quả, doanh nghiệp nên thực hiện theo từng bước thay vì chỉ tăng tài nguyên khi hệ thống bắt đầu chậm.
Bước 1: Đánh giá lưu lượng nhiệm vụ
Thu thập dữ liệu về số lượng yêu cầu, thời gian xử lý trung bình, thời gian chờ và tỷ lệ nhiệm vụ thất bại. Đây là cơ sở để xác định hàng đợi đang gặp vấn đề ở khâu nào.
Bước 2: Phân nhóm nhiệm vụ
Xác định các loại công việc mà AI đang thực hiện. Những nhiệm vụ có mức độ ưu tiên, thời gian xử lý và nhu cầu tài nguyên khác nhau nên được phân loại phù hợp.
Bước 3: Lựa chọn công nghệ hàng đợi
Tùy theo kiến trúc hệ thống, doanh nghiệp có thể cân nhắc:
- RabbitMQ: phù hợp với mô hình hàng đợi công việc và định tuyến thông điệp.
- Apache Kafka: phù hợp với hệ thống xử lý luồng dữ liệu và lưu lượng thông điệp lớn.
- Redis: hỗ trợ xây dựng hàng đợi có độ trễ thấp khi được triển khai với cơ chế phù hợp.
Bước 4: Thiết lập giới hạn và cơ chế phân phối
Cấu hình số lượng worker, mức độ ưu tiên, giới hạn tác vụ đồng thời và thời gian chờ tối đa. Đồng thời, cần xây dựng cơ chế xử lý lỗi để tránh nhiệm vụ bị mất hoặc thực hiện lặp ngoài ý muốn.
Bước 5: Theo dõi và điều chỉnh
Sau khi triển khai, tiếp tục đo lường hiệu suất để điều chỉnh cấu hình. Nếu hàng đợi liên tục tăng dù worker hoạt động hết công suất, doanh nghiệp có thể cần bổ sung tài nguyên hoặc tối ưu chính tác vụ AI.
6. Theo dõi hiệu suất hàng đợi bằng những chỉ số nào?
Một hệ thống hàng đợi được tối ưu cần có khả năng giám sát liên tục. Nếu chỉ nhìn vào số lượng nhiệm vụ hoàn thành, doanh nghiệp có thể bỏ qua tình trạng người dùng phải chờ quá lâu.
Một số chỉ số nên theo dõi gồm:
- Queue Length: Tổng số nhiệm vụ đang chờ xử lý.
- Queue Waiting Time: Thời gian một nhiệm vụ phải chờ trước khi được thực thi.
- Processing Time: Thời gian hệ thống cần để hoàn thành một nhiệm vụ.
- Throughput: Số lượng nhiệm vụ được xử lý trong một khoảng thời gian.
- Failure Rate: Tỷ lệ nhiệm vụ thất bại.
- Worker Utilization: Mức độ sử dụng tài nguyên của các worker.
Doanh nghiệp có thể sử dụng Prometheus và Grafana để thu thập, trực quan hóa các chỉ số vận hành. Với hệ thống AI Agent, những công cụ như LangSmith hoặc Langfuse còn hỗ trợ theo dõi quá trình thực thi, thời gian gọi mô hình và các bước sử dụng công cụ.
Việc kết hợp dữ liệu hàng đợi với dữ liệu thực thi AI giúp xác định chính xác nguyên nhân gây chậm, thay vì chỉ xử lý phần biểu hiện bên ngoài.
7. Những sai lầm cần tránh khi quản lý hàng đợi AI
Trong quá trình triển khai, một số cách tối ưu tưởng chừng đơn giản nhưng có thể khiến hệ thống hoạt động kém hiệu quả hơn.
- Tăng worker không kiểm soát: Có thể làm tăng áp lực lên GPU, API hoặc cơ sở dữ liệu.
- Không phân biệt loại nhiệm vụ: Tác vụ đơn giản có thể phải chờ phía sau những công việc phân tích phức tạp.
- Không giới hạn thời gian chờ: Nhiệm vụ lỗi hoặc không còn cần thiết vẫn tiếp tục chiếm vị trí trong hàng đợi.
- Thiếu cơ chế xử lý trùng lặp: Một yêu cầu có thể được thực hiện nhiều lần nếu hệ thống không kiểm soát trạng thái và tính lặp an toàn.
- Không giám sát hàng đợi: Doanh nghiệp chỉ phát hiện vấn đề khi người dùng phản ánh hệ thống phản hồi chậm.
Đặc biệt, cần xác định rõ nhiệm vụ nào có thể thử lại, nhiệm vụ nào cần hủy và nhiệm vụ nào phải được ưu tiên xử lý. Những quy tắc này giúp hệ thống vận hành ổn định hơn khi lưu lượng tăng đột biến.
Kết luận
Tối ưu hàng đợi là một phần quan trọng trong quá trình xây dựng hệ thống AI có khả năng xử lý nhiều nhiệm vụ cùng lúc. Bằng cách phân loại mức độ ưu tiên, kiểm soát số lượng tác vụ đồng thời, phân phối công việc qua worker và theo dõi hiệu suất, doanh nghiệp có thể giảm thời gian chờ và hạn chế tình trạng quá tải.
Thay vì chỉ tăng tài nguyên khi hệ thống chậm, doanh nghiệp nên xây dựng cơ chế quản lý hàng đợi ngay từ đầu. Đây là nền tảng giúp AI Agent, chatbot và các quy trình tự động hóa mở rộng quy mô mà vẫn duy trì hiệu quả vận hành.