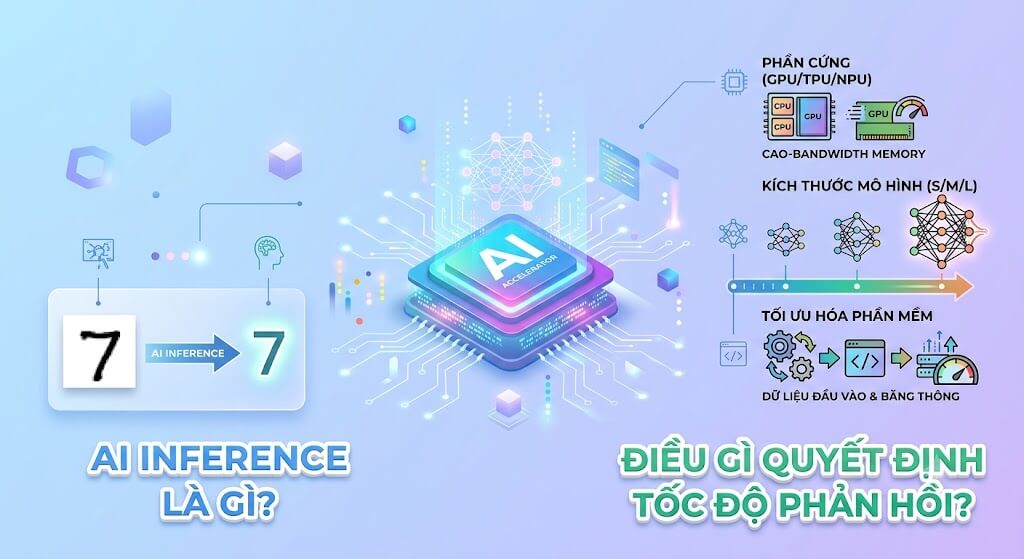
AI Inference là quá trình mô hình trí tuệ nhân tạo sử dụng kiến thức đã học để xử lý dữ liệu đầu vào và tạo ra kết quả. Mỗi khi người dùng đặt câu hỏi cho ChatGPT, yêu cầu AI viết nội dung, phân tích dữ liệu hoặc tạo hình ảnh, quá trình inference có thể được thực hiện để tạo ra phản hồi.
Tốc độ phản hồi là yếu tố quan trọng ảnh hưởng đến trải nghiệm sử dụng AI. Một hệ thống phản hồi nhanh giúp người dùng tiết kiệm thời gian, trong khi độ trễ lớn có thể làm gián đoạn quy trình làm việc. Vậy AI Inference hoạt động như thế nào và những yếu tố nào quyết định tốc độ xử lý của AI?
1. AI Inference Là Gì?
AI Inference, hay suy luận AI, là quá trình mô hình đã được huấn luyện sử dụng các tham số đã học để dự đoán, phân loại dữ liệu hoặc tạo ra nội dung mới dựa trên thông tin đầu vào.
Để hiểu rõ hơn, quá trình phát triển và sử dụng AI thường gồm hai giai đoạn chính:
- AI Training: Mô hình học từ dữ liệu để nhận diện quy luật và điều chỉnh các tham số.
- AI Inference: Mô hình sử dụng những gì đã học để xử lý yêu cầu thực tế và tạo ra kết quả.
Ví dụ, một mô hình ngôn ngữ được huấn luyện trên nhiều loại văn bản có thể học cách nhận diện ngữ cảnh và mối quan hệ giữa các từ. Khi người dùng yêu cầu viết email hoặc tóm tắt tài liệu, mô hình thực hiện inference để tạo nội dung phù hợp.
AI Inference được ứng dụng trong nhiều lĩnh vực như chatbot, nhận diện hình ảnh, dịch thuật, phân tích dữ liệu và hệ thống gợi ý sản phẩm. Với các mô hình ngôn ngữ lớn, quá trình này diễn ra mỗi khi hệ thống tiếp nhận và xử lý một yêu cầu mới.
2. AI Inference Hoạt Động Như Thế Nào?
Quá trình AI Inference có thể được chia thành các bước cơ bản sau:
Bước 1: Tiếp nhận dữ liệu đầu vào
Hệ thống nhận câu hỏi, văn bản, hình ảnh hoặc dữ liệu từ người dùng. Với mô hình ngôn ngữ, nội dung thường được chuyển thành các đơn vị nhỏ gọi là token để mô hình xử lý.
Bước 2: Xử lý thông tin
Mô hình sử dụng các tham số đã học để tính toán và xác định kết quả phù hợp với dữ liệu đầu vào. Đối với mô hình ngôn ngữ lớn, hệ thống dự đoán token tiếp theo dựa trên ngữ cảnh hiện có.
Bước 3: Tạo kết quả đầu ra
Mô hình lần lượt tạo ra các token để hình thành câu trả lời, bản tóm tắt hoặc đoạn mã theo yêu cầu. Quá trình tiếp tục cho đến khi hoàn thành nội dung hoặc đạt giới hạn được thiết lập.
Bước 4: Trả kết quả cho người dùng
Ứng dụng tiếp nhận kết quả, xử lý định dạng nếu cần và hiển thị nội dung. Thời gian phản hồi tổng thể còn phụ thuộc vào tốc độ truyền dữ liệu và các bước xử lý bên ngoài mô hình.
Ví dụ, khi người dùng yêu cầu AI tóm tắt một báo cáo dài, hệ thống cần xử lý lượng dữ liệu đầu vào lớn trước khi tạo bản tóm tắt. Vì vậy, thời gian phản hồi có thể lâu hơn so với một câu hỏi ngắn.
3. Những Yếu Tố Quyết Định Tốc Độ Phản Hồi Của AI
Tốc độ AI Inference không chỉ phụ thuộc vào mô hình mà còn chịu ảnh hưởng của phần cứng, dữ liệu đầu vào và cách hệ thống được triển khai.
3.1. Kích thước và kiến trúc mô hình
Mô hình có nhiều tham số thường cần nhiều tài nguyên tính toán và bộ nhớ hơn. Nếu chạy trên cùng một hệ thống phần cứng, mô hình lớn có thể phản hồi chậm hơn mô hình nhỏ.
Tuy nhiên, số lượng tham số không phải yếu tố duy nhất quyết định tốc độ. Kiến trúc mô hình, phương pháp tối ưu và loại tác vụ cũng ảnh hưởng đáng kể đến hiệu suất.
3.2. Phần cứng xử lý
GPU, CPU, bộ nhớ và băng thông truyền dữ liệu đều tác động đến tốc độ inference.
GPU có khả năng thực hiện nhiều phép tính song song, phù hợp với các phép tính trong mô hình AI. Ngoài sức mạnh tính toán, dung lượng bộ nhớ và tốc độ truyền dữ liệu cũng rất quan trọng, đặc biệt khi xử lý mô hình lớn hoặc nhiều yêu cầu cùng lúc.
3.3. Độ dài dữ liệu đầu vào
Yêu cầu càng dài thường cần nhiều thời gian xử lý ban đầu. Chẳng hạn, việc trả lời một câu hỏi đơn giản thường ít tốn thời gian hơn so với phân tích hàng trăm trang tài liệu.
Với mô hình ngôn ngữ lớn, giai đoạn xử lý prompt ban đầu được gọi là prefill. Giai đoạn này ảnh hưởng đến thời gian người dùng phải chờ trước khi nhận được token đầu tiên.
3.4. Độ dài câu trả lời
Các mô hình ngôn ngữ thường tạo nội dung theo từng token. Vì vậy, câu trả lời dài thường mất nhiều thời gian hơn để hoàn thành.
Ví dụ, yêu cầu AI đưa ra ba gợi ý thường cần ít thời gian sinh nội dung hơn yêu cầu viết một báo cáo chi tiết gồm nhiều phần phân tích. Tốc độ tạo token của mô hình cũng ảnh hưởng trực tiếp đến thời gian hoàn thành.
3.5. Số lượng người dùng đồng thời
Khi nhiều người gửi yêu cầu cùng lúc, hệ thống phải phân bổ tài nguyên cho nhiều tác vụ. Nếu lượng yêu cầu vượt quá khả năng xử lý, thời gian chờ có thể tăng lên.
Một số hệ thống sử dụng kỹ thuật batching, tức xử lý nhiều yêu cầu theo nhóm, để tận dụng tài nguyên hiệu quả hơn. Tuy nhiên, việc gom nhóm cần được tối ưu để cân bằng giữa hiệu suất tổng thể và thời gian chờ của từng người dùng.
3.6. Phần mềm và phương pháp tối ưu
Cách triển khai mô hình cũng ảnh hưởng đến tốc độ phản hồi. Một số kỹ thuật phổ biến gồm:
- Quantization: Giảm độ chính xác biểu diễn số của mô hình để tiết kiệm bộ nhớ và có thể tăng tốc xử lý.
- Caching: Lưu trữ một số kết quả hoặc trạng thái trung gian nhằm hạn chế tính toán lại khi phù hợp.
- Continuous batching: Linh hoạt bổ sung yêu cầu vào nhóm xử lý để tận dụng tài nguyên tốt hơn.
- Tối ưu attention: Giảm chi phí tính toán hoặc di chuyển dữ liệu trong quá trình xử lý.
Các phương pháp này có thể cải thiện tốc độ và giảm chi phí vận hành. Tuy nhiên, hiệu quả thực tế phụ thuộc vào mô hình, phần cứng và loại tác vụ. Một số kỹ thuật cũng có thể tạo ra sự đánh đổi giữa tốc độ và chất lượng đầu ra.
4. Những Chỉ Số Đánh Giá Tốc Độ AI Inference
Để đánh giá hiệu suất của một hệ thống AI, doanh nghiệp cần xem xét nhiều chỉ số thay vì chỉ đo tổng thời gian hoàn thành câu trả lời.
| Chỉ số | Ý nghĩa |
| Time to First Token (TTFT) | Thời gian từ khi gửi yêu cầu đến khi nhận được token đầu tiên. |
| Time Per Output Token (TPOT) | Thời gian trung bình để tạo mỗi token đầu ra sau token đầu tiên. |
| End-to-End Latency | Tổng thời gian từ khi gửi yêu cầu đến khi nhận được toàn bộ phản hồi. |
| Throughput | Lượng công việc hệ thống xử lý trong một khoảng thời gian, thường được đo bằng token/giây hoặc yêu cầu/giây. |
Trong đó, TTFT đặc biệt quan trọng với chatbot và trợ lý AI. Nếu hệ thống bắt đầu phản hồi nhanh, người dùng sẽ ít phải chờ đợi trước khi nhìn thấy nội dung đầu tiên.
Trong khi đó, throughput giúp đánh giá khả năng phục vụ nhiều yêu cầu. Một hệ thống có throughput cao chưa chắc phản hồi nhanh với từng người dùng, đặc biệt khi lượng truy cập tăng mạnh.
Doanh nghiệp nên kết hợp các chỉ số này để đánh giá hiệu suất trong điều kiện sử dụng thực tế, bao gồm cả thời điểm có nhiều người dùng truy cập đồng thời.
5. Cách Tối Ưu Tốc Độ AI Inference Trong Thực Tế
Doanh nghiệp có thể cải thiện tốc độ phản hồi của AI bằng cách tối ưu mô hình, dữ liệu đầu vào và hạ tầng triển khai.
Lựa chọn mô hình phù hợp: Không phải tác vụ nào cũng cần mô hình lớn. Với các yêu cầu như phân loại văn bản, trích xuất thông tin hoặc trả lời câu hỏi đơn giản, mô hình nhỏ hơn có thể đáp ứng tốt với chi phí thấp hơn.
Rút gọn dữ liệu đầu vào: Chỉ cung cấp những thông tin liên quan trực tiếp đến yêu cầu. Với hệ thống truy xuất tài liệu, nên chọn đúng những đoạn thông tin cần thiết thay vì gửi toàn bộ kho dữ liệu vào mô hình.
Kiểm soát độ dài đầu ra: Xác định rõ số lượng ý, độ dài hoặc định dạng câu trả lời để tránh tạo nội dung dài không cần thiết.
Tối ưu hạ tầng: Lựa chọn phần cứng phù hợp với kích thước mô hình và lượng truy cập dự kiến. Với hệ thống phục vụ nhiều người dùng, cần theo dõi hàng đợi và phân bổ tài nguyên hợp lý.
Theo dõi hiệu suất thường xuyên: Đo TTFT, thời gian hoàn thành yêu cầu, throughput và tỷ lệ lỗi trong điều kiện vận hành thực tế. Dữ liệu đo lường giúp xác định chính xác khâu đang gây chậm trễ.
Cân bằng tốc độ và chất lượng: Khi sử dụng quantization hoặc chuyển sang mô hình nhỏ hơn, cần kiểm tra độ chính xác trên các tác vụ quan trọng trước khi triển khai rộng rãi.
Kết luận
AI Inference là quá trình mô hình AI sử dụng kiến thức đã học để xử lý yêu cầu và tạo ra kết quả. Tốc độ phản hồi phụ thuộc vào kích thước mô hình, phần cứng, độ dài dữ liệu đầu vào và đầu ra, số lượng người dùng đồng thời cùng phương pháp tối ưu hệ thống.
Để cải thiện hiệu suất, doanh nghiệp nên lựa chọn mô hình phù hợp, giảm dữ liệu không cần thiết, tối ưu hạ tầng và theo dõi các chỉ số như TTFT, TPOT và throughput. Khi hiểu rõ những yếu tố này, doanh nghiệp có thể xây dựng hệ thống AI phản hồi nhanh hơn, sử dụng tài nguyên hiệu quả và nâng cao trải nghiệm người dùng.