Sự phát triển của trí tuệ nhân tạo (AI) giúp con người tạo ra những đoạn ghi âm có giọng nói tự nhiên, thậm chí bắt chước giọng của một người cụ thể chỉ từ một lượng mẫu âm thanh nhất định. Công nghệ này mang lại nhiều ứng dụng trong sản xuất nội dung, lồng tiếng và hỗ trợ giao tiếp. Tuy nhiên, nó cũng tạo ra nguy cơ giả mạo giọng nói để lừa đảo, đánh cắp thông tin hoặc mạo danh người khác.
Trước tình hình đó, các công nghệ phát hiện giọng nói giả mạo bằng AI ngày càng được quan tâm. Vậy AI nhận biết giọng nói thật và giọng nói được tạo ra hoặc chỉnh sửa bằng công nghệ như thế nào? Hãy cùng tìm hiểu các phương pháp phổ biến và cách ứng dụng trong thực tế.
AI phát hiện giọng nói giả mạo bằng cách nào?
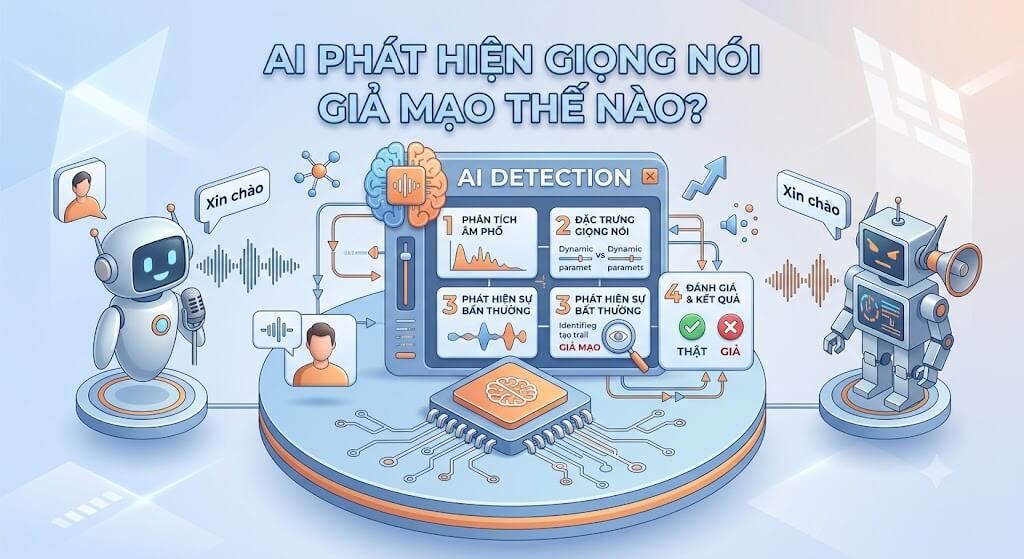
AI phát hiện giọng nói giả mạo bằng cách phân tích các đặc điểm của tín hiệu âm thanh, tìm kiếm dấu hiệu bất thường và đánh giá khả năng một đoạn ghi âm là giọng nói tự nhiên hay âm thanh đã được tổng hợp, chỉnh sửa hoặc giả mạo.
Quá trình này thường sử dụng các mô hình học máy và học sâu được huấn luyện trên nhiều mẫu âm thanh khác nhau. Trong đó, hệ thống học cách phân biệt những đặc điểm thường xuất hiện ở giọng nói thật với những dấu hiệu có thể liên quan đến âm thanh nhân tạo.
1. Phân tích đặc điểm của tín hiệu âm thanh
Khi con người nói, giọng nói tạo ra các tín hiệu âm thanh có sự thay đổi liên tục về cao độ, cường độ, nhịp điệu và tần số. Những đặc điểm này hình thành từ hoạt động của cơ quan phát âm, cách lấy hơi và thói quen nói của mỗi người.
Giọng nói giả mạo được tạo bằng AI có thể mô phỏng nhiều đặc điểm trên, nhưng đôi khi vẫn xuất hiện những dấu hiệu bất thường trong tín hiệu âm thanh.
Hệ thống phát hiện có thể phân tích các yếu tố như:
- Tần số và phổ âm thanh: Xem xét sự phân bố năng lượng ở các dải tần khác nhau.
- Cao độ giọng nói: Phân tích sự thay đổi cao độ trong quá trình phát âm.
- Nhịp điệu và khoảng ngắt: Kiểm tra cách ngắt nghỉ giữa các từ, cụm từ và câu.
- Đặc điểm phát âm: Tìm những dấu hiệu bất thường trong cách hình thành âm thanh.
Ví dụ, một đoạn ghi âm giả mạo có thể nghe khá tự nhiên khi phát lại thông thường nhưng vẫn chứa những đặc điểm âm học khác với dữ liệu giọng nói thật mà hệ thống đã học.
Tuy nhiên, không có một dấu hiệu riêng lẻ nào đủ để kết luận chắc chắn rằng giọng nói là giả. Các công nghệ tổng hợp giọng nói hiện đại có thể tái tạo âm thanh rất chân thực, vì vậy hệ thống cần kết hợp nhiều đặc điểm để đưa ra đánh giá.
2. Nhận diện những bất thường trong cách phát âm
Ngoài tín hiệu âm thanh, AI có thể phân tích cách các âm được phát ra và nối với nhau trong lời nói.
Trong một số trường hợp, giọng nói tổng hợp có thể xuất hiện cách chuyển tiếp giữa các âm chưa tự nhiên, phụ âm thiếu rõ ràng hoặc cách nhấn giọng không phù hợp với ngữ cảnh. Một số hệ thống phát hiện được huấn luyện để nhận diện những khác biệt tinh vi này.
Chẳng hạn, khi một hệ thống tạo giọng nói nhân tạo đọc một câu dài, phần lớn từ ngữ có thể được phát âm chính xác nhưng cách nhấn vào từ quan trọng hoặc chuyển giọng ở cuối câu đôi khi vẫn thiếu tự nhiên.
AI có thể sử dụng các đặc điểm này như một phần dữ liệu để phân loại âm thanh. Dù vậy, giọng nói của con người cũng có thể không rõ ràng do mệt mỏi, căng thẳng, nói nhanh hoặc chất lượng ghi âm kém. Vì thế, việc đánh giá cần dựa trên nhiều yếu tố thay vì chỉ dựa vào cách phát âm.
3. Phân tích đặc điểm giọng nói theo thời gian
Giọng nói của con người không duy trì một trạng thái cố định trong suốt cuộc trò chuyện. Cao độ, âm lượng, tốc độ và cách nhấn giọng thay đổi theo cảm xúc, nội dung và tình huống giao tiếp.
Một số hệ thống AI phân tích sự thay đổi này theo từng khoảng thời gian để tìm ra các mẫu âm thanh bất thường.
Ví dụ, trong một cuộc gọi giả mạo, giọng nói có thể nghe tự nhiên ở đầu câu nhưng chuyển tiếp giữa các từ hoặc các đoạn âm thanh lại thiếu liền mạch. Nếu đoạn ghi âm được ghép từ nhiều nguồn khác nhau, hệ thống cũng có thể tìm thấy sự khác biệt về âm lượng, tiếng nền hoặc đặc điểm âm học tại vị trí nối.
Tuy nhiên, những bất thường này cũng có thể xuất hiện khi người dùng chỉnh sửa âm thanh hợp pháp, sử dụng thiết bị ghi âm khác nhau hoặc tham gia cuộc gọi có kết nối không ổn định. Vì vậy, kết quả phân tích chỉ nên được xem là dấu hiệu cần kiểm tra thêm.
4. So sánh với dữ liệu giọng nói thật
Một phương pháp khác là so sánh đoạn âm thanh cần kiểm tra với dữ liệu tham chiếu đã được xác thực.
Trong một số hệ thống xác minh người nói, AI có thể tạo ra biểu diễn đặc trưng của giọng nói, thường được gọi là voice embedding. Biểu diễn này giúp hệ thống so sánh mức độ tương đồng giữa các mẫu giọng nói.
Ví dụ, khi một tổ chức cần xác minh người gọi có đúng là người đã đăng ký tài khoản hay không, hệ thống có thể so sánh giọng nói hiện tại với mẫu giọng nói đã được lưu hợp pháp trước đó.
Tuy nhiên, cần phân biệt hai nhiệm vụ:
- Xác minh người nói: Đánh giá xem hai mẫu âm thanh có khả năng thuộc về cùng một người hay không.
- Phát hiện giọng nói giả mạo: Đánh giá xem âm thanh có dấu hiệu được tạo ra hoặc can thiệp bằng phương pháp giả mạo hay không.
Hai nhiệm vụ có thể được kết hợp trong một hệ thống, nhưng không hoàn toàn giống nhau. Một đoạn âm thanh có thể giống giọng của một người thật nhưng vẫn được tạo bằng AI. Vì vậy, chỉ so sánh giọng nói không phải lúc nào cũng đủ để phát hiện giả mạo.
5. Sử dụng mô hình học sâu để phân loại âm thanh
Nhiều hệ thống phát hiện giọng nói giả mạo sử dụng mạng nơ-ron sâu để học các đặc điểm phân biệt từ dữ liệu âm thanh.
Trong quá trình huấn luyện, mô hình được cung cấp các mẫu giọng nói thật và mẫu giọng nói giả được tạo bằng những phương pháp khác nhau. Từ dữ liệu đó, mô hình học cách nhận diện những mẫu đặc trưng có khả năng liên quan đến âm thanh giả mạo.
Khi nhận được một đoạn ghi âm mới, hệ thống phân tích dữ liệu và đưa ra kết quả phân loại hoặc điểm số thể hiện mức độ nghi ngờ.
Chẳng hạn, hệ thống có thể đánh dấu một cuộc gọi là có nguy cơ sử dụng giọng nói nhân tạo để nhân viên kiểm tra thêm. Kết quả này không nhất thiết đồng nghĩa với việc người gọi đang thực hiện hành vi lừa đảo, bởi âm thanh giả cũng có thể xuất hiện trong những ứng dụng hợp pháp.
Độ chính xác của mô hình phụ thuộc vào dữ liệu huấn luyện, chất lượng âm thanh và mức độ tương đồng giữa các kiểu giả mạo mới với những mẫu hệ thống từng được học.
Quy trình AI phát hiện giọng nói giả mạo trong thực tế
Một hệ thống phát hiện thường thực hiện nhiều bước liên tiếp để phân tích và đánh giá âm thanh.
Bước 1: Thu thập âm thanh. Hệ thống nhận dữ liệu từ bản ghi âm, cuộc gọi hoặc tệp âm thanh được cung cấp để kiểm tra.
Bước 2: Tiền xử lý dữ liệu. Âm thanh có thể được chuẩn hóa, giảm nhiễu và chuyển thành dạng dữ liệu phù hợp với mô hình phân tích.
Bước 3: Trích xuất đặc trưng. Hệ thống phân tích phổ âm thanh, cao độ, nhịp điệu và các đặc điểm liên quan.
Bước 4: Phân tích bằng mô hình AI. Mô hình đánh giá các đặc điểm thu được để tìm dấu hiệu liên quan đến giọng nói tổng hợp hoặc âm thanh giả mạo.
Bước 5: Trả về kết quả. Hệ thống đưa ra điểm số, mức độ nghi ngờ hoặc cảnh báo để người dùng xem xét. Tùy thiết kế, kết quả có thể được kết hợp với xác minh danh tính hoặc các biện pháp bảo mật khác.
Trong những ứng dụng quan trọng như ngân hàng hoặc xác minh danh tính, kết quả phát hiện thường cần được kết hợp với nhiều lớp kiểm tra khác thay vì sử dụng AI làm căn cứ duy nhất.
Những công cụ hỗ trợ phát hiện giọng nói giả mạo
Một số nền tảng và công nghệ được phát triển để phân tích âm thanh giả mạo, xác minh người nói hoặc hỗ trợ nghiên cứu về deepfake giọng nói.
- Resemble AI: Cung cấp các giải pháp liên quan đến tạo giọng nói tổng hợp và phát hiện nội dung âm thanh giả mạo, tùy sản phẩm và gói dịch vụ.
- Pindrop: Tập trung vào bảo mật giọng nói, phát hiện gian lận trong các tương tác qua điện thoại và hỗ trợ xác minh người gọi.
- ElevenLabs: Được biết đến với công nghệ tạo giọng nói AI và có các tính năng liên quan đến phát hiện nội dung âm thanh được tạo bằng AI trong hệ sinh thái sản phẩm của mình.
- Các mô hình nghiên cứu chống giả mạo giọng nói: Một số mô hình được phát triển để phân biệt giọng nói thật với âm thanh tổng hợp hoặc phát lại, phục vụ nghiên cứu và xây dựng hệ thống bảo mật.
Không phải mọi công cụ đều hoạt động giống nhau hoặc có thể kiểm tra mọi loại tệp âm thanh. Trước khi sử dụng, người dùng nên kiểm tra khả năng hỗ trợ ngôn ngữ, định dạng tệp, điều kiện sử dụng và phạm vi phát hiện của từng sản phẩm.
AI có thể phát hiện giọng nói giả mạo chính xác 100% không?
Câu trả lời là không. Dù công nghệ phát hiện ngày càng tiến bộ, việc phân biệt giọng nói thật và giả vẫn là một thách thức.
Một số nguyên nhân chính gồm:
Công nghệ giả mạo ngày càng tinh vi: Các mô hình tạo giọng nói mới có thể tạo ra âm thanh tự nhiên hơn và giảm những dấu hiệu bất thường mà hệ thống cũ thường nhận diện.
Chất lượng âm thanh không đồng đều: Tiếng ồn, âm thanh bị nén, đường truyền kém hoặc bản ghi bị cắt ghép có thể khiến việc phân tích khó khăn hơn.
Khác biệt về ngôn ngữ và giọng địa phương: Hệ thống được huấn luyện trên một nhóm dữ liệu nhất định có thể hoạt động kém hiệu quả hơn với những giọng nói chưa xuất hiện nhiều trong dữ liệu huấn luyện.
Nguy cơ nhận diện sai: Giọng nói thật có thể bị đánh dấu nhầm là giả, trong khi một đoạn âm thanh nhân tạo tinh vi có thể vượt qua hệ thống kiểm tra.
Vì vậy, kết quả từ AI không nên được coi là bằng chứng tuyệt đối. Với những tình huống liên quan đến tài chính, danh tính hoặc an ninh, cần kết hợp xác minh qua kênh độc lập và các biện pháp bảo mật khác.
Cách tự bảo vệ trước hành vi giả mạo giọng nói
Bên cạnh công nghệ phát hiện, người dùng cũng nên chủ động phòng tránh các hình thức lừa đảo sử dụng giọng nói AI.
- Xác minh qua kênh khác: Nếu nhận cuộc gọi yêu cầu chuyển tiền hoặc cung cấp thông tin nhạy cảm, hãy gọi lại số điện thoại đã biết hoặc liên hệ trực tiếp với người được cho là đang gọi.
- Không chỉ dựa vào giọng nói: Giọng nói giống người thân, đồng nghiệp hoặc cấp trên không đủ để xác nhận danh tính.
- Thiết lập quy tắc xác minh nội bộ: Gia đình hoặc doanh nghiệp có thể thống nhất một câu hỏi xác minh riêng cho các tình huống bất thường.
- Không cung cấp mã xác thực: Tuyệt đối không chia sẻ mật khẩu, mã OTP hoặc thông tin tài khoản chỉ vì người gọi có giọng nói quen thuộc.
- Kiểm tra yêu cầu khẩn cấp: Những cuộc gọi tạo áp lực phải chuyển tiền ngay hoặc giữ bí mật với người khác cần được xem xét cẩn thận.
Những biện pháp này đặc biệt quan trọng vì không phải lúc nào người dùng cũng có sẵn công cụ chuyên dụng để phân tích âm thanh.
Kết luận
AI phát hiện giọng nói giả mạo bằng cách phân tích tín hiệu âm thanh, nhận diện những đặc điểm bất thường, so sánh mẫu giọng nói và sử dụng các mô hình học sâu để đánh giá nguy cơ giả mạo. Công nghệ này có thể hỗ trợ bảo vệ người dùng trước những hình thức lừa đảo sử dụng giọng nói nhân tạo.
Tuy nhiên, không có hệ thống nào bảo đảm phát hiện chính xác mọi trường hợp. Để tăng mức độ an toàn, cần kết hợp công nghệ AI với quy trình xác minh danh tính, kiểm tra thông tin qua kênh độc lập và nâng cao nhận thức về các thủ đoạn giả mạo. Đây là cách tiếp cận thiết thực để tận dụng lợi ích của AI mà vẫn hạn chế những rủi ro do công nghệ này gây ra.