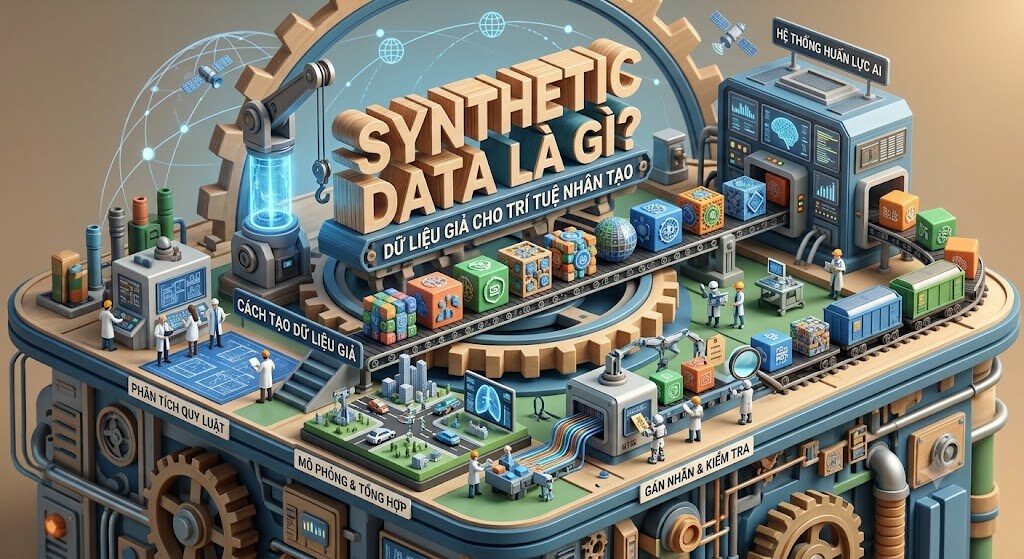
Synthetic Data là gì? Tìm hiểu cách tạo dữ liệu tổng hợp phục vụ huấn luyện AI, những lợi ích, hạn chế và cách doanh nghiệp sử dụng dữ liệu giả để phát triển mô hình hiệu quả hơn.
Dữ liệu là yếu tố quan trọng quyết định chất lượng của mô hình trí tuệ nhân tạo (AI). Tuy nhiên, không phải doanh nghiệp nào cũng có đủ dữ liệu thực tế để huấn luyện AI, đặc biệt khi dữ liệu chứa thông tin cá nhân hoặc khó thu thập với số lượng lớn.
Synthetic Data trở thành giải pháp đáng chú ý trong trường hợp này. Vậy Synthetic Data là gì, được tạo ra như thế nào và doanh nghiệp có thể sử dụng dữ liệu tổng hợp để huấn luyện AI ra sao?
1. Synthetic Data Là Gì?
Synthetic Data, hay dữ liệu tổng hợp, là dữ liệu được tạo ra bằng thuật toán, mô hình thống kê hoặc AI thay vì thu thập trực tiếp từ các sự kiện thực tế. Dữ liệu này được thiết kế để mô phỏng những đặc điểm và quy luật của dữ liệu thật, phục vụ các mục đích như huấn luyện, kiểm thử và đánh giá mô hình AI.
Ví dụ, một doanh nghiệp thương mại điện tử muốn xây dựng AI dự đoán khả năng khách hàng mua hàng. Thay vì sử dụng toàn bộ lịch sử giao dịch thực tế, doanh nghiệp có thể tạo dữ liệu tổng hợp gồm các trường như độ tuổi theo nhóm, số lần truy cập, giá trị đơn hàng và hành vi mua sắm giả lập.
Nếu được tạo đúng cách, dữ liệu tổng hợp có thể giúp mô hình học những mối quan hệ cần thiết mà không phải sử dụng trực tiếp mọi bản ghi khách hàng thật.
Synthetic Data thường được tạo theo ba phương pháp chính:
- Phương pháp thống kê: Sử dụng phân phối xác suất và các quy luật thống kê để tạo dữ liệu mới có đặc điểm tương tự dữ liệu gốc.
- Mô hình AI tạo sinh: Sử dụng các mô hình như GAN hoặc mô hình khuếch tán để tạo dữ liệu văn bản, hình ảnh hay dữ liệu có cấu trúc.
- Mô phỏng theo quy tắc: Xây dựng các kịch bản và quy tắc để tạo dữ liệu phù hợp với một tình huống cụ thể.
Cần lưu ý rằng dữ liệu tổng hợp không mặc nhiên phản ánh chính xác thực tế hoặc bảo đảm an toàn tuyệt đối về quyền riêng tư. Chất lượng của dữ liệu phụ thuộc vào phương pháp tạo, dữ liệu tham chiếu và quy trình kiểm tra.
2. Synthetic Data Khác Gì Dữ Liệu Thực Tế?
Dữ liệu thực tế được thu thập từ hoạt động hoặc sự kiện đã xảy ra, chẳng hạn giao dịch mua hàng, phản hồi khách hàng và kết quả kiểm tra sản phẩm. Trong khi đó, Synthetic Data được tạo ra để tái hiện những đặc điểm cần thiết của dữ liệu phục vụ một mục tiêu cụ thể.
Tiêu chí | Synthetic Data | Dữ liệu thực tế |
| Nguồn tạo | Thuật toán, AI hoặc mô phỏng | Hoạt động và sự kiện thực tế |
| Khả năng mở rộng | Có thể tạo số lượng lớn theo nhu cầu | Phụ thuộc nguồn thu thập |
| Chi phí | Có thể giảm chi phí thu thập và xử lý | Có thể tốn chi phí làm sạch, gắn nhãn |
| Quyền riêng tư | Có thể giảm việc sử dụng dữ liệu cá nhân thật | Có thể chứa thông tin nhạy cảm |
| Độ sát thực tế | Phụ thuộc chất lượng phương pháp tạo | Phản ánh sự kiện đã ghi nhận |
| Rủi ro | Có thể thiếu đa dạng hoặc sai lệch | Có thể chứa dữ liệu nhiễu và thiên lệch |
Hai loại dữ liệu này không nhất thiết phải thay thế nhau. Trong nhiều trường hợp, kết hợp dữ liệu thực tế với dữ liệu tổng hợp sẽ giúp mô hình học tốt hơn, đặc biệt khi dữ liệu thật còn thiếu ở một số tình huống hiếm gặp.
3. Lợi Ích Của Synthetic Data Trong Huấn Luyện AI
Bổ sung dữ liệu khi nguồn thực tế còn hạn chế
Một số bài toán AI cần lượng dữ liệu lớn hoặc nhiều trường hợp đặc biệt. Synthetic Data giúp tạo thêm ví dụ để huấn luyện mô hình, chẳng hạn hình ảnh sản phẩm lỗi hoặc các tình huống khách hàng ít khi gặp.
Giảm chi phí thu thập và gắn nhãn
Việc thu thập, phân loại và gắn nhãn dữ liệu thực tế có thể tốn nhiều thời gian. Dữ liệu tổng hợp được tạo theo cấu trúc định sẵn có thể giảm một phần công việc này, nhất là với các bài toán có tiêu chí rõ ràng.
Hỗ trợ bảo vệ quyền riêng tư
Doanh nghiệp có thể sử dụng dữ liệu tổng hợp thay cho một phần dữ liệu cá nhân trong quá trình phát triển và kiểm thử AI. Tuy nhiên, nếu dữ liệu được tạo bằng cách ghi nhớ hoặc sao chép quá sát dữ liệu gốc, nguy cơ lộ thông tin vẫn có thể tồn tại.
Mô phỏng các tình huống khó
Synthetic Data cho phép tạo ra những kịch bản hiếm gặp, chẳng hạn giao dịch bất thường, lỗi thiết bị hoặc tình huống tấn công mạng giả lập. Nhờ đó, mô hình có thêm cơ hội học cách nhận diện những trường hợp khó phát hiện trong dữ liệu thông thường.
4. Cách Tạo Synthetic Data Phục Vụ Huấn Luyện AI
Để tạo dữ liệu tổng hợp có giá trị, doanh nghiệp cần xác định mục tiêu trước khi lựa chọn phương pháp thực hiện.
Bước 1: Xác định bài toán AI
Trước tiên, hãy làm rõ mô hình cần giải quyết vấn đề gì, chẳng hạn dự đoán nhu cầu, phân loại hình ảnh hoặc phát hiện giao dịch bất thường. Mục tiêu này quyết định loại dữ liệu và đặc điểm cần mô phỏng.
Bước 2: Chuẩn bị dữ liệu tham chiếu
Nếu có dữ liệu thực tế, doanh nghiệp cần kiểm tra chất lượng, loại bỏ thông tin không cần thiết và xác định những đặc điểm quan trọng. Với một số bài toán, dữ liệu tham chiếu có thể được thay thế bằng quy tắc nghiệp vụ hoặc mô phỏng chuyên ngành.
Bước 3: Lựa chọn phương pháp tạo dữ liệu
Dữ liệu dạng bảng có thể được tạo bằng mô hình thống kê hoặc mô hình sinh dữ liệu chuyên dụng. Với hình ảnh, doanh nghiệp có thể sử dụng mô hình tạo sinh. Đối với dữ liệu vận hành, mô phỏng theo quy tắc có thể phù hợp hơn.
Bước 4: Kiểm tra chất lượng dữ liệu
Sau khi tạo dữ liệu, cần kiểm tra tính hợp lý, mức độ đa dạng và khả năng phản ánh các tình huống thực tế. Những dữ liệu sai quy tắc hoặc lặp lại quá nhiều cần được xử lý trước khi đưa vào huấn luyện.
Bước 5: Huấn luyện và đánh giá mô hình
Sử dụng dữ liệu tổng hợp để huấn luyện hoặc bổ sung cho mô hình, sau đó đánh giá trên một tập dữ liệu thực tế độc lập nếu có. Cách làm này giúp xác định liệu mô hình có thực sự cải thiện hay chỉ ghi nhớ những quy luật nhân tạo.
5. Những Hạn Chế Khi Sử Dụng Synthetic Data
Dù mang lại nhiều lợi ích, Synthetic Data vẫn có những giới hạn doanh nghiệp cần cân nhắc.
Thứ nhất, dữ liệu tổng hợp có thể tái tạo những sai lệch từ dữ liệu tham chiếu. Nếu dữ liệu ban đầu thiếu đại diện cho một nhóm đối tượng, dữ liệu được tạo thêm cũng có thể tiếp tục thiếu sót đó.
Thứ hai, dữ liệu nhân tạo đôi khi quá đơn giản hoặc không phản ánh đầy đủ những biến động trong thực tế. Mô hình được huấn luyện bằng nguồn dữ liệu này có thể đạt kết quả tốt trong thử nghiệm nhưng hoạt động kém khi triển khai thật.
Thứ ba, việc tạo dữ liệu chất lượng cao cần kiến thức chuyên môn và quy trình đánh giá phù hợp. Doanh nghiệp không nên chỉ tăng số lượng dữ liệu mà bỏ qua tính chính xác và mức độ hữu ích.
Vì vậy, cần kiểm tra dữ liệu tổng hợp bằng các chỉ số thống kê, đánh giá mức độ đa dạng và thử nghiệm mô hình trên những dữ liệu độc lập. Với các ứng dụng quan trọng, việc kết hợp dữ liệu tổng hợp và dữ liệu thực tế thường là hướng tiếp cận an toàn hơn.
Kết luận
Synthetic Data là giải pháp giúp doanh nghiệp tạo dữ liệu phục vụ huấn luyện, kiểm thử và đánh giá AI khi nguồn dữ liệu thực tế còn hạn chế hoặc khó sử dụng. Công nghệ này có thể giảm chi phí chuẩn bị dữ liệu, hỗ trợ mô phỏng tình huống hiếm gặp và hạn chế việc tiếp xúc trực tiếp với thông tin nhạy cảm.
Tuy nhiên, dữ liệu tổng hợp chỉ thực sự hữu ích khi được tạo đúng mục tiêu và kiểm tra chất lượng nghiêm túc. Doanh nghiệp nên kết hợp phương pháp tạo dữ liệu phù hợp với quy trình đánh giá độc lập để bảo đảm mô hình AI hoạt động hiệu quả trong môi trường thực tế.